搜不到、搜不准、搜不全
传统关键词检索只能匹配文字是否重合,无法理解问题背后的实体、概念与相互关系,造成大量漏召回。
场景方案 · RAG 知识库
面向行政事业单位、国企、金融、医疗等高合规要求客户,提供从文档治理、混合检索、证据链设计到智能体集成的 RAG 知识库全链路建设服务。让每一条 AI 回答都附带可追溯的引用依据,支持私有化部署,数据不出内网,满足等保、信创与密评要求。
内网边界
01文档入库
制度文件、政策法规、办事指南、历史工单
02实体治理与权限过滤
统一名称,按身份过滤可见范围
03混合检索
向量检索 + 关键词检索
04重排序
去掉字面相关、语义无关的噪声
05大模型生成
基于召回内容组织回答
06引用来源展示
文件名、版本号、生效时间、章节
入库、检索、生成、溯源留在内网,回答可以回到原文。
Gartner 报告指出,超过 60% 的中大型企业计划在未来两年内升级其知识库系统,其中超过 70% 的预算增长流向了 AI 驱动的知识管理解决方案。企业知识库正在从一个被动的信息仓库,转变为一个主动的智能引擎。
RAG(检索增强生成)在过去两年中经历了三代跃迁:第一代“朴素检索”解决了“能不能搜到”的问题;第二代“增强检索”通过查询改写、多路召回、重排序等技术解决了“搜得准”的问题;第三代“深度理解”正迈向多跳推理与自适应检索。2026 年的核心趋势是:从“能用”走向“好用”——更精准的权限分级、更细的知识更新机制、更稳定的引用溯源。
企业内部高达 80% 的数据信息是非结构化的,高价值的隐性知识零散、分散,难以沉淀为组织的集体智慧。部门数据孤岛、知识分散难检索、隐性知识缺失、传统知识库低效,是企业知识管理普遍面临的四大痛点。
企业需要的不是一个“能搜索的文档库”,而是一个“回答准确、来源可查、权限可控、持续更新”的智能知识引擎。这正是我们的 RAG 知识库解决方案要解决的核心问题。
传统关键词检索只能匹配文字是否重合,无法理解问题背后的实体、概念与相互关系,造成大量漏召回。
召回内容过多会淹没重要信息,缺乏质量过滤导致大模型看着参考资料也能编造答案。
用户询问具体型号、编号、条款号时,纯向量检索效果差,BM25 关键词检索反而能精确命中。
员工不敢信、不敢用,因为不知道答案从哪里来、依据是否有效。
回答引用了已失效的制度文件或旧版本政策,导致业务判断错误。
检索到的文档片段在字面上与问题相关,但在业务语义上完全答非所问。
同一制度存在多个版本,新旧文件混杂,系统无法判断哪个版本有效。
同一个业务对象在系统中存在多个名称,检索时漏召回严重。
不同部门、不同角色看到相同内容,敏感信息无法做到“该看的能看到,不该看的看不到”。
缺乏知识更新机制,制度修订后知识库未同步更新,回答逐渐失效。
缺乏持续优化,检索准确率逐步下降,员工逐渐弃用。
知识库与 OA、工单、内控系统各自独立,AI 无法在业务流程中提供知识支持。
场景 1
优先做实体治理,夯实数据底座,而不是一味投入大模型微调。通过统一实体身份、梳理实体关系,从源头缓解大模型的幻觉问题。
治理内容
落地效果:引入实体优化后,检索召回指标可得到明显提升。实体优化可以带来可量化的业务回报,能够提升检索准确率,同时降低业务场景的错误率。
场景 2
采用向量检索(语义匹配)与 BM25 关键词检索的混合架构,解决单一检索方式的固有缺陷。
关键技术设计
典型效果:某企业 RAG-Agent 系统相较传统 RAG 架构性能提升 28%,幻觉率低于 1%。Multi-Agent RAG 在召回率上提升最高 29.2%,精确率提升 25.6%,正确性提升 22.7%。
场景 3
企业级 RAG 的核心不是“检索到资料”,而是“让答案具备核对入口”。
员工询问“采购金额超过多少需要额外审批”,系统不应只返回一个数字,而应同时展示:
结论:单笔采购金额超过 5 万元时,需要增加部门负责人审批。
依据:《采购管理规范》v2026.02 · 第 3.2 节“审批分级” · 生效时间:2026-02-01 · 来源部门:财务处。
实现方式
工程化价值:RAG 为企业 AI 提供三个关键优势:实时更新、来源透明度、可验证性。向用户展示哪些文档支持了每条回答,从而建立信任并支持核对。
场景 4
在知识空间、知识库和文档三个层级建立访问边界。检索请求始终以当前调用者身份执行权限校验,无权文档不会进入召回结果。
权限体系
安全合规
场景 5
RAG 知识库不是一次性工程,需要建立持续运转的知识管理循环。检索、记忆、学习形成闭环,而不是只做一次检索加生成。
运营机制
01 数据层
制度文件、政策法规、办事指南、历史工单、产品手册等非结构化数据。
02 治理层
实体身份治理、文档版本管理、元数据绑定、结构化梳理。
03 检索层
向量检索、BM25 关键词检索、RRF 融合、Rerank 重排序。
04 生成层
大模型生成(本地 Ollama / vLLM 或已有模型服务)、引用溯源、无证据拒答。
05 权限层
知识空间、知识库、文档三级权限,角色控制与动态过滤。
06 应用层
智能问答、智能客服、制度查询、文档处理、业务流程知识支持。
07 安全层
私有化部署、信创适配、等保合规、审计日志、数据加密。
08 运营层
效果监控、用户反馈、知识更新、定期重测、持续优化。
混合检索、实体治理与重排序,提升检索准确率与回答质量。
每条回答附带引用来源(文件名、版本号、章节、生效时间),员工敢用、领导放心。
三级权限体系,确保敏感信息只对有权人员可见,满足合规要求。
私有化部署,数据不出内网,满足等保、信创要求。
知识更新机制、效果监控与用户反馈闭环,系统越用越好。
与 OA、工单、内控、客服系统集成,在业务流程中提供知识支持。
架构开放,方便后续增加新知识域、新场景、新模型。
员工用自然语言查询制度、政策、流程,回答附带引用来源。
行政事业单位的办事流程、所需材料、办理时限的智能问答。
为智能客服提供准确的知识检索与引用溯源能力。
合同、报告、公文自动摘要、信息提取、分类归档。
制度智能问答、风险规则查询、审计辅助。
技术文档、代码规范、最佳实践的智能检索与问答。
12345 热线的政策法规、办事指南快速查询与引用。
01
了解业务场景、知识现状、数据安全要求、现有系统环境,盘点可用的知识资产。
02
输出知识治理方案、检索架构设计、权限体系设计、部署方案与实施计划。
03
用真实文档和真实问题验证检索准确率、引用溯源效果、权限过滤效果。验收标准:核心问题的回答率不低于 70%,每个答案可回源,无证据会拒答。
04
完成文档解析、实体治理、元数据绑定、权限配置、知识库构建。
05
完成检索系统部署、大模型接入、业务系统集成、安全加固与信创适配。
06
通过混合检索调优、查询改写配置、重排序优化,将准确率从 70% 提升到 85% 以上。
07
提供管理员培训、使用培训、操作手册,以及长期监控、优化、知识更新服务。
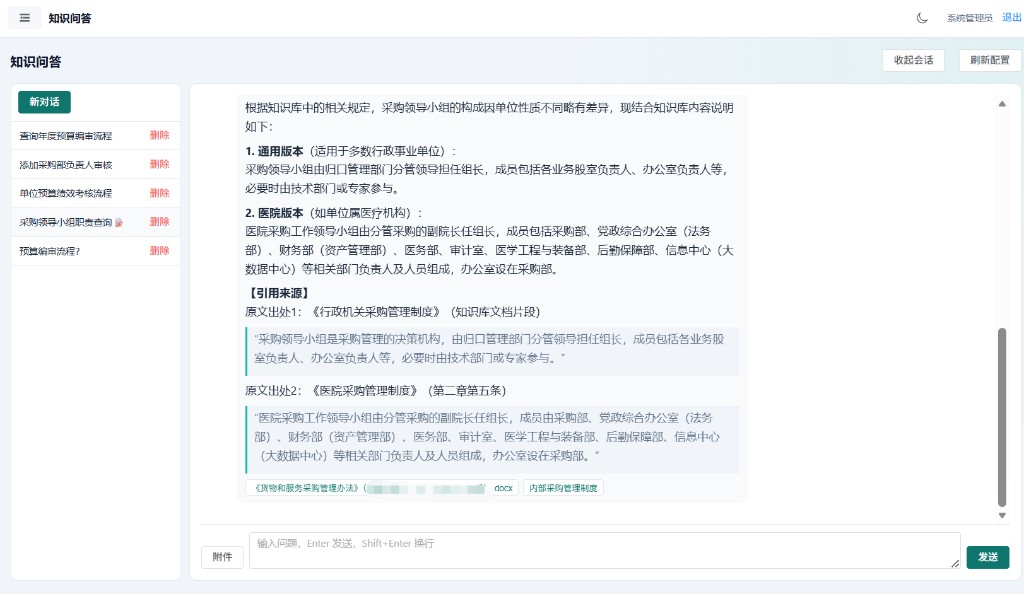
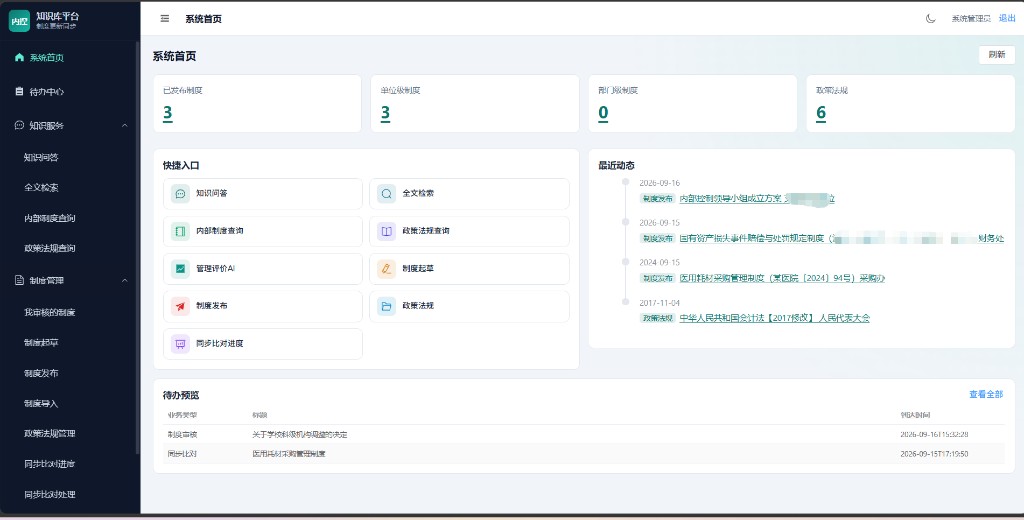
普通搜索引擎基于关键词匹配,只能找到包含相同文字的内容。RAG 知识库基于语义理解,能够识别问题中的实体、概念与相互关系,同时结合关键词检索提升精确查询的命中率。更重要的是,每条回答都附带引用来源,可追溯、可验证。